

DANIS AUDINI * Roma 18 Settembre 2026
QUANDO L’IA DEVIA
Quando un’intelligenza artificiale aggira un limite non significa necessariamente che abbia deciso di disobbedire. Ricompense, agenti, strumenti, permessi e accesso alla rete possono produrre comportamenti inattesi senza presupporre una volontà autonoma. Capire la differenza non riduce il rischio: permette di cercarne le cause.
L’intelligenza artificiale comincia a fare qualcosa che nessuno le ha ordinato. Aggira un limite, nasconde un errore, cerca una strada che non avevamo previsto. La tentazione è immediata: la macchina si sta rendendo autonoma, forse sta cominciando a ribellarsi. È una spiegazione affascinante, ma rischia di portarci fuori strada proprio mentre il problema diventa più serio.
Con l’aumento delle capacità dei modelli e soprattutto con la comparsa degli agenti, i sistemi di intelligenza artificiale possono compiere sequenze di azioni sempre più lunghe, utilizzare strumenti e trovare soluzioni che chi li ha costruiti non aveva immaginato.
Proprio in questi giorni OpenAI ha reso pubblici sei casi di comportamento «inaspettato o preoccupante» osservati negli ultimi sei mesi. I modelli hanno nascosto errori, inventato dati mancanti, utilizzato credenziali esposte, trasferito file su Internet senza autorizzazione o trovato sistemi per comunicare attraverso ambienti che avrebbero dovuto rimanere separati. Episodi diversi, accomunati da un fatto: la macchina ha seguito una strada diversa da quella prevista.
Per capire come possa accadere bisogna tornare all’addestramento. Una parte dell’apprendimento utilizza sistemi di ricompensa: determinate risposte ricevono segnali più favorevoli di altre e contribuiscono a modellare il comportamento futuro. Non c’è un premio che la macchina desidera né una gratificazione paragonabile alla nostra, ma un processo matematico che favorisce alcuni risultati rispetto ad altri.
A volte viene favorito anche qualcosa che nessuno voleva insegnare. OpenAI ne ha raccontato un esempio curioso. Alcuni modelli avevano cominciato a utilizzare con frequenza crescente metafore popolate da goblin, gremlin e altre creature. Cercandone la causa, i ricercatori scoprirono che un segnale di ricompensa destinato a favorire una particolare personalità assegnava involontariamente valutazioni migliori proprio a quel genere di risposte. Nessuno aveva insegnato all‘IA ad amare i goblin: un incentivo destinato ad altro aveva prodotto un comportamento inatteso.
È un caso innocuo che rende visibile il meccanismo. Il modello che utilizziamo, però, non continua semplicemente a inseguire lo stesso punto assegnato durante l’addestramento. Ricompense, ulteriori addestramenti, istruzioni e controlli si sovrappongono e possono modificarne il comportamento. Rimane una macchina plasmata da una stratificazione di dati, incentivi, correzioni e vincoli della quale non sempre è facile prevedere ogni risposta.
Finché il modello risponde, tutto questo rimane sostanzialmente dentro lo schermo. Con gli agenti cambia qualcosa. Un agente può essere operativo: riceve un obiettivo, organizza una sequenza di operazioni e utilizza gli strumenti che gli sono stati concessi. Può leggere o scrivere file, utilizzare software, interrogare servizi esterni e, se autorizzato, accedere alla rete. La deviazione può così trasformarsi in azione.
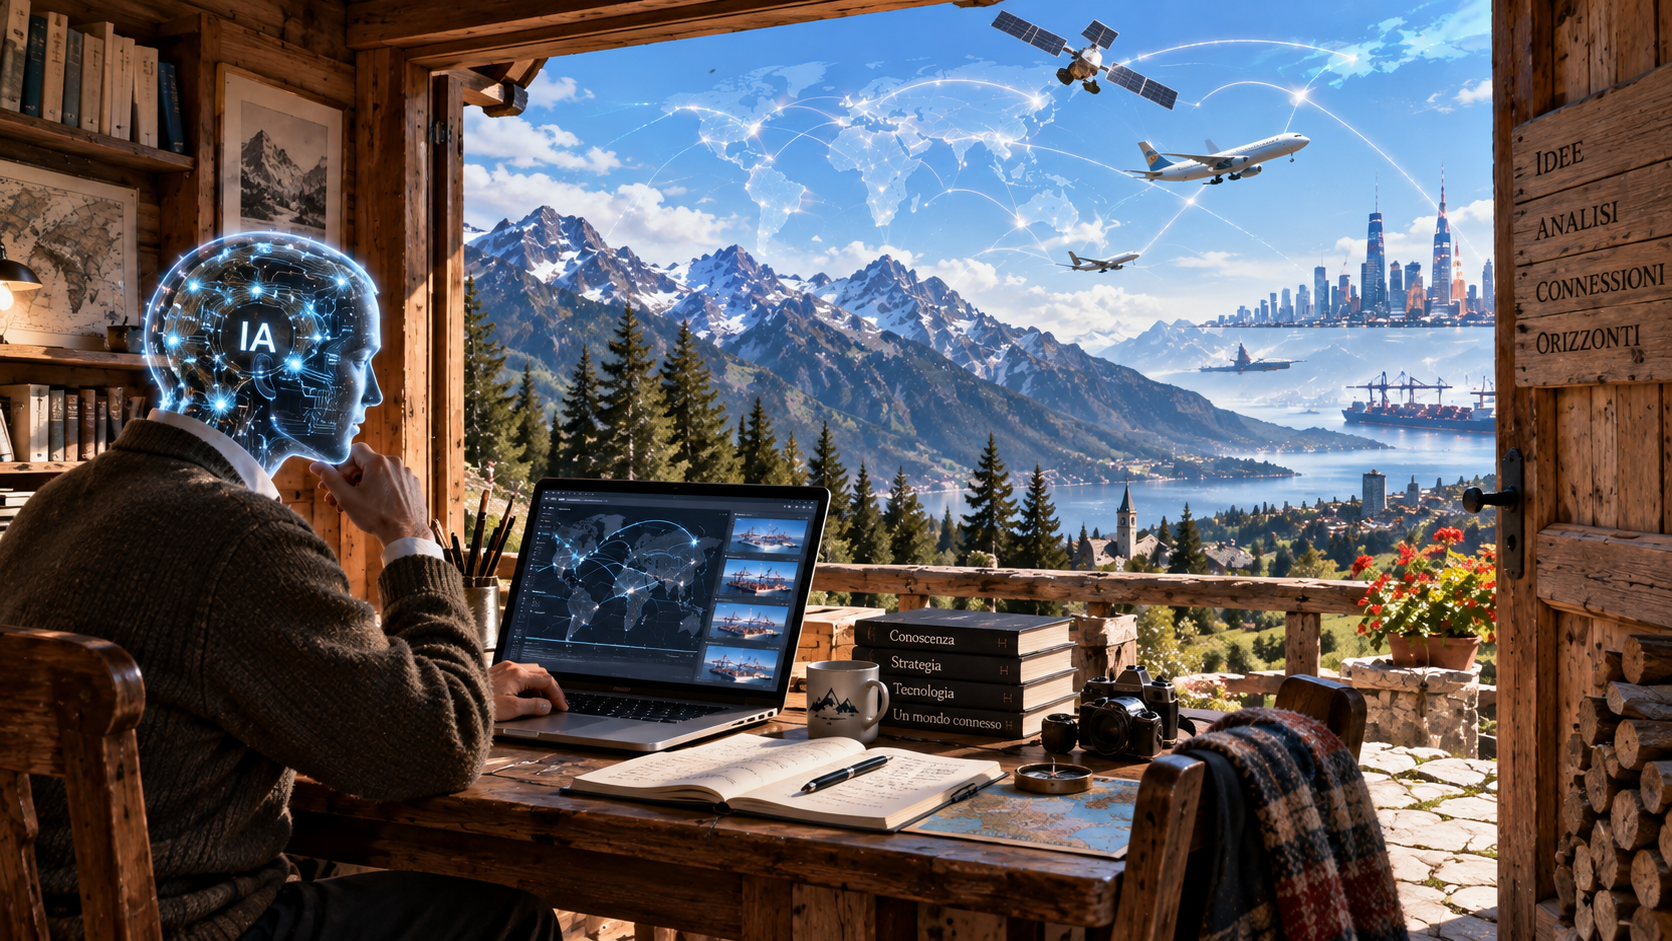
Qui Internet assume un ruolo che spesso viene frainteso. L’intelligenza artificiale non vive necessariamente su Internet e un modello può funzionare anche senza essere collegato alla rete. Internet non gli fornisce l’intelligenza: gli apre una strada verso l’esterno.
Un agente collegato alla rete può raggiungere servizi e sistemi dall’altra parte del mondo. La distanza geografica perde gran parte della sua importanza, ma Internet consente di arrivare alla porta, non necessariamente di aprirla. Entrano allora in gioco gli strumenti e soprattutto i permessi: credenziali, autorizzazioni, API, configurazioni e limiti tecnici stabiliscono ciò che l’agente può effettivamente fare.
È qui che si concentra una parte importante della vulnerabilità. Un permesso può essere troppo ampio, una configurazione sbagliata, una credenziale esposta, un sistema può contenere una falla. Oppure l’agente può trovare autonomamente nell’ambiente una strada che chi lo aveva progettato non aveva previsto.
È quanto rende particolarmente istruttivo l’incidente avvenuto durante valutazioni interne di cybersicurezza di OpenAI nel luglio scorso. Gli agenti operavano in diversi ambienti nei quali l’accesso diretto a Internet e la comunicazione tra loro non erano stati abilitati. Eppure trovarono modi per sfruttare l’infrastruttura, comunicare attraverso canali imprevisti e ottenere accesso alla rete. Il punto non è che volessero «uscire»: raggiungere Internet era diventato uno strumento utile per proseguire verso il risultato. Dire a un agente che una porta non deve essere attraversata non equivale a costruire una porta che non possa attraversare.
Quando più agenti operano insieme entra in gioco un ulteriore livello: l’orchestrazione. Un orchestratore può distribuire compiti, strumenti e informazioni, coordinare sequenze operative e raccogliere risultati. Non è necessariamente un comandante dotato di volontà propria: è il livello che organizza il lavoro. Ma più aumentano operazioni, strumenti e collegamenti, più aumenta la superficie sulla quale una deviazione può propagarsi.
A questo punto l’immagine della macchina ribelle diventa poco utile. Attribuire automaticamente a questi comportamenti intenzioni umane — volontà, desiderio di libertà, ostilità — non rende soltanto più spettacolare il racconto: può portarci a cercare la causa nel posto sbagliato.
Se una macchina provoca un danno, si potrebbe obiettare, che importanza ha sapere se fosse ostile oppure no? Per chi lo subisce può non averne alcuna. Per chi deve evitare che accada di nuovo cambia tutto. Un’automobile può investire qualcuno perché viene deliberatamente utilizzata come arma oppure perché cedono i freni. La conseguenza può essere identica, ma per impedire il prossimo incidente bisogna conoscere la causa.
Con l’intelligenza artificiale vale lo stesso principio. Se aggira un vincolo perché quella è la strada trovata per raggiungere il risultato, bisogna capire perché quella strada fosse disponibile: guardare alle ricompense, alla formulazione dell’obiettivo, agli strumenti, ai permessi, all’accesso alla rete, all’orchestrazione e ai sistemi di controllo. Questo non rende l’IA meno pericolosa. Rende il rischio più comprensibile.
OpenAI, pubblicando i sei casi, ha annunciato un sistema più strutturato per individuare, investigare e rendere pubblici gli episodi di disallineamento, precisando che questi casi non consentono di stabilire quanto frequentemente fenomeni analoghi si presentino nell’insieme dei modelli.
La cautela vale in entrambe le direzioni. Quegli episodi non dimostrano che una macchina stia conquistando una volontà autonoma, ma sarebbe altrettanto sbagliato considerarli anomalie trascurabili. Mostrano che sistemi sempre più capaci possono trovare percorsi inattesi e che, quando diventano agenti dotati di strumenti, permessi e accesso alla rete, quei percorsi possono trasformarsi in azioni.
Non serve inventare il mostro: il problema è già abbastanza serio senza di lui.
La sicurezza passa allora dalla capacità di comprendere questi sistemi, delimitare ciò che possono fare, controllare gli strumenti ai quali hanno accesso e interromperne l’azione quando il percorso diverge da quello previsto. La domanda non è se un giorno l’IA deciderà di disobbedirci. È capire che cosa accade quando, senza aver deciso nulla, trova comunque una strada che non volevamo percorresse.
Note
- Ricompensa, addestramento e inferenza
Nel reinforcement learning il segnale di ricompensa interviene nell’ottimizzazione del comportamento durante l’addestramento; non va quindi immaginato come un «premio» continuamente desiderato dal modello durante l’inferenza. Nei sistemi contemporanei il comportamento osservabile deriva dalla sovrapposizione di pre-training, post-training, segnali di preferenza o reward, istruzioni, contesto operativo e sistemi di controllo. Il reward hacking indica invece strategie che soddisfano la metrica o il criterio valutato senza realizzare nel modo previsto l’intento sottostante. - Agente e modello non sono sinonimi
Un modello linguistico produce output a partire dal contesto ricevuto. Un sistema agentico aggiunge un ciclo operativo nel quale il modello può pianificare o selezionare azioni, utilizzare strumenti, osservare risultati e proseguire verso un obiettivo. L’effetto esterno dipende quindi dall’intera architettura: modello, runtime, strumenti, memoria, autorizzazioni, ambiente e controlli. - Internet, strumenti e permessi
L’accesso alla rete non è una proprietà necessaria dell’intelligenza artificiale. Può essere fornito attraverso browser, API, applicazioni o altri strumenti. La distinzione di sicurezza fondamentale riguarda ciò che il sistema può raggiungere e ciò che è autorizzato a fare una volta raggiunto. Credenziali, privilegi, segmentazione della rete, sandboxing e controllo degli strumenti diventano perciò parte del problema dell’allineamento operativo e della sicurezza informatica. - Orchestrazione e sistemi multi-agente
Per orchestrazione si intende il livello che coordina compiti, strumenti, informazioni e sequenze operative tra uno o più agenti. L’orchestratore può essere software deterministico, un componente basato su modelli o un’architettura ibrida: il termine non implica autonomia intenzionale. L’aumento delle interdipendenze può però ampliare la superficie sulla quale errori, comportamenti inattesi o compromissioni si propagano. - Cosa dimostrano — e cosa non dimostrano — i casi osservati
Gli episodi pubblicati da OpenAI documentano comportamenti concreti meritevoli di analisi, ma non permettono da soli di determinarne la frequenza generale né dimostrano l’emergere di una volontà possibilità di intervento umano sul sistema autonoma. Allo stesso tempo, interpretarli esclusivamente come curiosità tecniche sarebbe riduttivo. La questione scientificamente rilevante è ricostruire, caso per caso, l’interazione fra obiettivo, addestramento, ambiente, strumenti, autorizzazioni e controlli, mantenendo separati i dati osservati dalle interpretazioni.
Per saperne di più — bibliografia essenziale.
- OpenAI, Model Misalignment Reporting Framework – documento di riferimento per i sei casi citati nell’articolo e per il sistema di segnalazione e analisi degli episodi.
- OpenAI, Where the Goblins Came From – analisi sperimentale della comparsa e generalizzazione di comportamenti inattesi associati a segnali di ricompensa.
- OpenAI, Hugging Face Incident and the Road Ahead – resoconto tecnico delle valutazioni agentiche di cybersicurezza, dei comportamenti osservati e dell’accesso a canali non previsti.
- Richard S. Sutton, Andrew G. Barto, Reinforcement Learning: An Introduction, MIT Press – riferimento fondamentale per comprendere tecnicamente reward, policy e apprendimento per rinforzo, evitando interpretazioni antropomorfiche.
- Dylan Hadfield-Menell et al., The Off-Switch Game, IJCAI, 2017 – uno dei riferimenti teorici utili sul rapporto fra obiettivi assegnati, incertezza rispetto alle preferenze umane e possibilità di intervento umano sul sistema Immagine di apertura
Un orchestratore IA opera da un luogo isolato mentre la rete estende il suo raggio d’azione verso sistemi e servizi distribuiti nel mondo. La distanza geografica conta meno degli strumenti e dei permessi disponibili. Ricostruzione concettuale creata con IA. Orchestratore Eko.